AI Chạy Nội Bộ Và Mô Hình Ngôn Ngữ Nhỏ (SLM): Chọn Thế Nào?
Nhiều lãnh đạo doanh nghiệp Việt Nam có chung một nỗi lo khi nghe đến AI: "Nếu nhân viên dán dữ liệu khách hàng, hợp đồng, bảng giá vào một công cụ AI trên mạng, dữ liệu đó đi đâu?" Câu trả lời quen thuộc là "vậy thì mình tự chạy AI trong nội bộ, dùng mô hình nhỏ cho nhẹ". Nghe hợp lý, nhưng câu trả lời này gộp ba quyết định khác nhau làm một: dữ liệu nào cần giữ kín, mô hình nào đủ năng lực cho việc đó, và ai chịu trách nhiệm vận hành an toàn.
Bài này không nhằm thuyết phục bạn nên hay không nên dùng AI chạy nội bộ hay mô hình ngôn ngữ nhỏ (SLM). Mục tiêu là giúp bạn tách ba quyết định đó ra, biết điều gì đã có bằng chứng và điều gì mới chỉ là lập luận, và có một kế hoạch chạy thử 30–60 ngày để tự kiểm chứng trước khi đầu tư.
Minh bạch: Phanmembiz là đơn vị triển khai Zoho, nên bài có nhắc đến mô hình ngôn ngữ của Zoho (Zia LLM) như một ví dụ về hướng "AI do nhà cung cấp phần mềm tự vận hành". Chúng tôi chỉ dựa vào tài liệu công khai của Zoho và nêu cả những điều tài liệu đó chưa nói rõ. Phần còn lại của bài áp dụng cho mọi nhà cung cấp.
1. "AI chạy nội bộ" và "SLM" là hai khái niệm khác nhau
Hai cụm từ này thường đi cùng nhau nhưng trả lời hai câu hỏi khác nhau:
- AI chạy nội bộ trả lời câu hỏi "mô hình chạy ở đâu và ai kiểm soát máy chủ?".
- SLM (mô hình ngôn ngữ nhỏ) trả lời câu hỏi "mô hình lớn cỡ nào?".
Bạn có thể chạy một mô hình rất lớn trong trung tâm dữ liệu của chính mình, và ngược lại có thể dùng một mô hình nhỏ do nhà cung cấp chạy trên cloud của họ. Vì vậy, trước khi bàn nên chọn gì, hãy phân biệt các cách triển khai:
| Cách triển khai | Mô hình chạy ở đâu | Ai vận hành | Ví dụ |
|---|---|---|---|
| Trên thiết bị (on-device) | Máy tính hoặc điện thoại của nhân viên | Từng người dùng | Một nhân viên chạy mô hình nhỏ trên laptop để tóm tắt tài liệu |
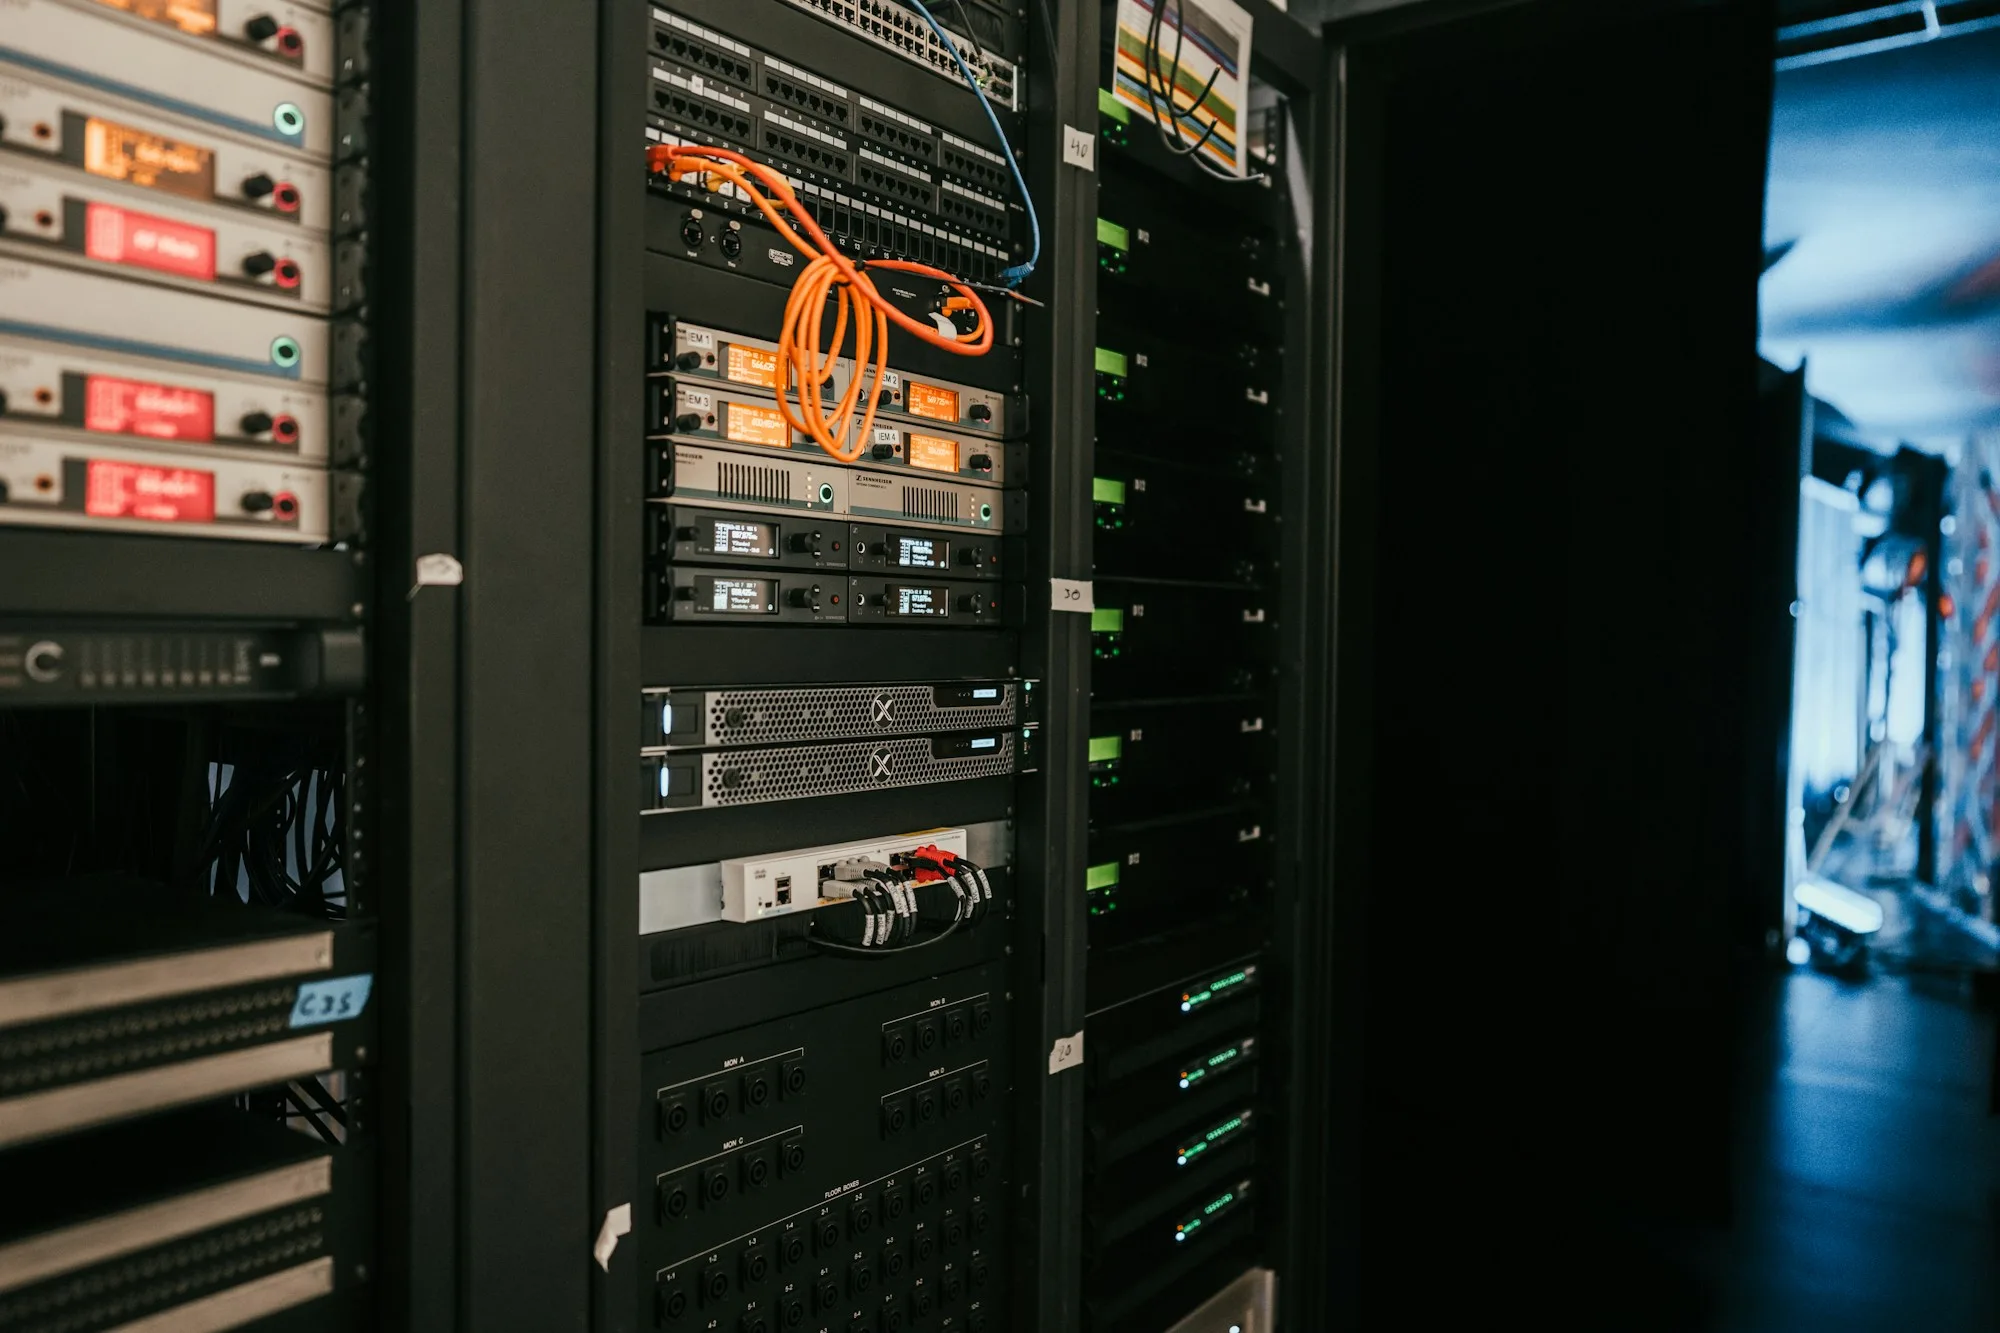
| Máy chủ nội bộ (on-premise) | Máy chủ đặt tại văn phòng hoặc phòng máy của công ty | Bộ phận IT của công ty | Công ty mua máy chủ có GPU, dựng mô hình cho các phòng ban dùng |
| Cloud riêng (private cloud) | Hạ tầng thuê của nhà cung cấp cloud, tách riêng cho công ty | Công ty tự vận hành trên hạ tầng thuê | Thuê máy ảo có GPU, tự cài mô hình |
| AI do nhà cung cấp phần mềm tự vận hành | Trung tâm dữ liệu của nhà cung cấp phần mềm | Nhà cung cấp | Zia LLM chạy trong trung tâm dữ liệu của Zoho |
| AI dùng chung qua API | Hạ tầng của nhà cung cấp mô hình bên thứ ba | Nhà cung cấp mô hình | Gọi API của một dịch vụ AI công cộng |
Về chữ "nhỏ": hiện chưa có định nghĩa chuẩn cho SLM. Một bài viết quan điểm của nhóm tác giả gắn với NVIDIA Research ("Small Language Models are the Future of Agentic AI") định nghĩa SLM theo khả năng triển khai: mô hình đủ nhỏ để chạy trên thiết bị điện tử tiêu dùng thông thường, và trong thực tế là "hầu hết các mô hình dưới 10 tỷ tham số" (arXiv 2506.02153). Đây là cách định nghĩa của một nhóm tác giả, không phải tiêu chuẩn ngành. Khi một nhà cung cấp nói "mô hình nhỏ", hãy hỏi lại họ đang nói đến bao nhiêu tham số.
Điểm cần nhớ: "nội bộ" là chuyện kiểm soát và vận hành, "nhỏ" là chuyện năng lực và chi phí. Hai câu hỏi cần được trả lời riêng.
2. SLM làm được gì, và chưa chắc làm được gì
Lập luận ủng hộ SLM. Bài viết của nhóm NVIDIA Research lập luận rằng SLM đã đủ năng lực cho nhiều tác vụ lặp lại, hẹp và có cấu trúc (phân loại yêu cầu, trích xuất thông tin, gọi công cụ theo mẫu), và rẻ hơn khi vận hành. Cần đọc kèm hai điều:
- Đây là bài viết trình bày quan điểm (position paper), và NVIDIA là hãng bán GPU.
- Con số "rẻ hơn khoảng 10–30 lần" (về độ trễ, năng lượng, khối lượng tính toán) được trích từ các nguồn bên ngoài chứ không phải do nhóm tác giả tự đo. Chính các tác giả cũng thừa nhận về lợi thế quy mô thì "vẫn chưa ngã ngũ" (the jury is still out).
Tín hiệu cảnh báo. Một nghiên cứu độc lập của một tác giả (Laksh Advani, đăng ngày 1/1/2026) kiểm tra Llama-3-8B, Mistral-7B và Qwen-2.5-7B trên ba bộ bài toán GSM8K, HotpotQA và ARC với 10.734 chuỗi lập luận, và báo cáo rằng trung bình 50–69% câu trả lời đúng (tùy mô hình) chứa lập luận có lỗi. Cung cấp đúng tài liệu liên quan giúp lập luận tốt hơn, còn để mô hình tự phê bình lại thường làm kết quả tệ đi (arXiv 2601.00513). Lưu ý: bài chưa qua bình duyệt, chỉ có một tác giả, và các bài toán bằng tiếng Anh. Nên xem đây là lý do để kiểm tra kỹ, không phải kết luận.
Một ảnh chụp khác. Blog của Intel (15/4/2024) báo cáo mô hình Neural-chat 7B có tỷ lệ ảo giác 2,8%, so với 3% của GPT-4, trên bảng đánh giá HHEM của Vectara (Intel). Đây chỉ là tác vụ tóm tắt từ văn bản cho sẵn, tại một thời điểm, trên phiên bản đánh giá cũ, và đồng tác giả là hãng bán chip. Không nên suy ra "SLM ít ảo giác hơn" từ đây.
Còn tiếng Việt thì sao? Đã có các mô hình và bộ đánh giá riêng cho tiếng Việt, ví dụ PhoGPT của VinAI (PhoGPT-4B có 3,7 tỷ tham số, huấn luyện trên 102 tỷ token tiếng Việt, ngữ cảnh 8.192 token) (arXiv 2311.02945). Nhưng chúng tôi không tìm thấy bằng chứng độc lập nào về hiệu quả của SLM trong tác vụ doanh nghiệp bằng tiếng Việt (soạn email bán hàng, tóm tắt hợp đồng, trả lời theo tài liệu nội bộ). Điều đó không có nghĩa SLM không đủ tốt; nó có nghĩa bạn không thể dựa vào các bảng điểm chung để quyết định.
Cách làm thực tế: coi câu hỏi "SLM có đủ dùng không" là câu hỏi phải thử trên chính tác vụ của bạn (xem mục 8), không phải câu hỏi có đáp án sẵn.
3. Chạy nội bộ không tự động an toàn
Lý do chính khiến doanh nghiệp muốn chạy AI nội bộ là để dữ liệu không rời khỏi tầm kiểm soát. Hướng đi đó đúng, nhưng bạn cũng nhận về toàn bộ trách nhiệm bảo mật cho máy chủ AI.
Số liệu về máy chủ AI tự dựng bị để lộ. Ollama là phần mềm phổ biến để chạy mô hình ngôn ngữ trên máy riêng. Các báo cáo gần đây cho thấy:
- SentinelOne và Censys ghi nhận khoảng 175.000 máy chủ Ollama công khai trên Internet ở 130 quốc gia trong 293 ngày quan sát, và gần một nửa có bật tính năng gọi công cụ (tool-calling), nghĩa là kẻ tấn công có thể không chỉ đọc mà còn kích hoạt hành động (SentinelLABS).
- LeakIX (2/2026) đếm được 12.269 máy chủ Ollama không yêu cầu xác thực (LeakIX).
- Lỗ hổng "Bleeding Llama" (CVE-2026-7482, điểm CVSS 9,1) do Cyera phát hiện có thể ảnh hưởng khoảng 300.000 máy chủ, và đã được vá ở Ollama 0.17.1 (Cloud Security Alliance). Lỗ hổng trước đó "Probllama" (CVE-2024-37032) được vá từ bản 0.1.34 (Wiz).
Chúng tôi không nói riêng Ollama kém an toàn; nó là ví dụ cho một vấn đề chung: công cụ dễ cài thường mở cổng mặc định, và người cài (không phải chuyên gia bảo mật) dễ để nguyên như vậy.
Rủi ro đặc thù của ứng dụng AI. Danh sách OWASP Top 10 cho ứng dụng mô hình ngôn ngữ (2025) gồm: (1) tiêm lệnh (prompt injection), (2) lộ thông tin nhạy cảm, (3) chuỗi cung ứng, (4) đầu độc dữ liệu và mô hình, (5) xử lý đầu ra không an toàn, (6) trao quyền quá mức cho AI, (7) lộ lời nhắc hệ thống, (8) điểm yếu của vector và embedding, (9) thông tin sai lệch, (10) tiêu thụ tài nguyên không kiểm soát (OWASP). Các rủi ro này tồn tại dù mô hình chạy ở đâu.
Chuỗi cung ứng mô hình. JFrog (27/2/2024) báo cáo khoảng 100 mô hình độc hại trên Hugging Face, một số lợi dụng cơ chế của định dạng pickle để chạy mã khi nạp mô hình (JFrog). Định dạng safetensors được thiết kế để tránh loại rủi ro này. Vì vậy cần quy định rõ ai được tải mô hình nào, từ đâu.
Phân quyền khi AI đọc tài liệu nội bộ. Nếu bạn nối AI với kho tài liệu (kỹ thuật RAG), AI có thể trả lời bằng nội dung mà người hỏi không có quyền xem. Cần bảo đảm AI chỉ truy xuất những tài liệu mà chính người hỏi được phép đọc; đây là điều nên yêu cầu ở bất kỳ giải pháp nào.
Danh sách kiểm tra tối thiểu khi tự dựng (đề xuất của chúng tôi, dựa trên các khuyến nghị giảm thiểu rủi ro ở trên):
- Không mở dịch vụ AI trực tiếp ra Internet; đặt sau một lớp trung gian (reverse proxy) có xác thực.
- Chỉ cho dịch vụ lắng nghe trên máy cục bộ hoặc mạng nội bộ, không phải mọi giao diện mạng.
- Cập nhật bản vá thường xuyên và theo dõi thông báo lỗ hổng của công cụ đang dùng.
- Tắt các chức năng cho phép tải mô hình từ xa nếu không cần.
- Tắt tính năng gọi công cụ (tool-calling) nếu chưa có nhu cầu.
- Chỉ tải mô hình từ nguồn đã được phê duyệt, ưu tiên định dạng safetensors.
- Ghi nhật ký ai hỏi gì, và quy định thời gian lưu nhật ký (bản thân nhật ký cũng là dữ liệu nhạy cảm).
- Chỉ định một người chịu trách nhiệm, không để "ai rảnh thì làm".
Điểm cần nhớ: chạy nội bộ biến rủi ro "dữ liệu đi ra ngoài" thành rủi ro "mình tự bảo vệ máy chủ". Nếu công ty chưa có người làm bảo mật hạ tầng, đây không phải lựa chọn đơn giản hơn. Các rủi ro khi kết nối AI với nhiều hệ thống cũng được bàn trong bài MCP là gì.
4. Phần cứng và chi phí: điều tính được và điều chưa tính được
Chúng tôi không đưa giá GPU hay máy chủ, vì chưa có nguồn giá đáng tin và giá thay đổi rất nhanh. Thay vào đó là một phép tính số học đơn giản về bộ nhớ cần để chứa mô hình: số tham số × số bit mỗi tham số ÷ 8.
| Mô hình (số tham số) | Độ chính xác | Bộ nhớ cho trọng số (ước tính) |
|---|---|---|
| 3 tỷ | 4 bit | khoảng 1,5 GB |
| 7 tỷ | 4 bit | khoảng 3,5 GB |
| 7 tỷ | 16 bit | khoảng 14 GB |
| 14 tỷ | 4 bit | khoảng 7 GB |
| 70 tỷ | 4 bit | khoảng 35 GB |
| 70 tỷ | 16 bit | khoảng 140 GB |
Đây là tính toán sơ bộ của chúng tôi, chưa gồm bộ nhớ đệm cho ngữ cảnh (KV cache) và phần dư của phần mềm, nên mức cần thực tế sẽ cao hơn.
Bảng này chỉ nói một điều: mô hình nhỏ vừa với máy thông thường, còn mô hình lớn cần phần cứng chuyên dụng. Nhưng chi phí thật không chỉ là phần cứng. Khi lập dự toán, hãy liệt kê đủ các khoản:
- Phần cứng hoặc thuê hạ tầng có GPU; điện và làm mát nếu đặt tại chỗ.
- Nhân sự cài đặt, vá lỗi, giám sát và xử lý sự cố.
- Thời gian thử nghiệm, tinh chỉnh, đánh giá chất lượng.
- Tuân thủ: đánh giá rủi ro, hồ sơ, tư vấn pháp lý.
- Giấy phép của từng mô hình: mỗi mô hình mở có điều khoản riêng (một số hạn chế dùng thương mại hoặc kèm điều kiện), cần đọc kỹ từng giấy phép.
- Chi phí cơ hội nếu chất lượng thấp khiến nhân viên phải sửa lại nhiều.
Bài chi phí triển khai AI trong doanh nghiệp phân tích kỹ hơn các khoản chi phí ẩn.
5. Khung pháp lý cần kiểm tra
Lưu ý: phần này chỉ là tóm tắt để định hướng, không phải tư vấn pháp lý.
- Luật Bảo vệ dữ liệu cá nhân (Luật số 91/2025/QH15) và Nghị định 356/2025/NĐ-CP, có hiệu lực từ 1/1/2026, đặt ra các quy định về xử lý dữ liệu cá nhân, trong đó có dữ liệu nhạy cảm, và hồ sơ đánh giá tác động khi chuyển dữ liệu cá nhân ra nước ngoài (nộp trong 60 ngày kể từ khi bắt đầu chuyển, do cơ quan công an thẩm định).
- Câu hỏi còn mở: lưu dữ liệu trên máy chủ cloud ở nước ngoài có bị coi là chuyển dữ liệu xuyên biên giới không? Theo cách chúng tôi đọc Nghị định 356, khả năng cao là có, và câu hỏi này áp dụng như nhau cho Microsoft 365, Zoho hay bất kỳ dịch vụ AI nước ngoài nào. Đây là một lý do khiến AI chạy trong nước hoặc nội bộ được cân nhắc, nhưng hãy hỏi luật sư thay vì tự suy diễn. Phân tích chi tiết hơn có trong bài bảo mật dữ liệu khách hàng y tế trên CRM.
- Luật Trí tuệ nhân tạo (Luật số 134/2025/QH15), thông qua ngày 10/12/2025 với 429/434 đại biểu tán thành, có hiệu lực từ 1/3/2026, gồm 8 chương, 35 điều. Luật phân loại hệ thống AI theo mức rủi ro cao, trung bình, thấp (Điều 9), yêu cầu người dùng phải nhận biết được khi đang tương tác với AI (Điều 11), và liệt kê các hành vi bị cấm (Điều 7). Hệ thống AI đã vận hành trước ngày luật có hiệu lực có 12 tháng để tuân thủ (đến 1/3/2027), riêng y tế, giáo dục, tài chính là 18 tháng (đến 1/9/2027) (bản tiếng Anh trên LuatVietnam).
- Bí mật kinh doanh và quy định nội bộ: việc nhân viên đưa tài liệu nội bộ vào công cụ AI liên quan đến quy định lao động và bí mật kinh doanh; xem mẫu chính sách sử dụng AI nội bộ.
6. Lựa chọn thứ ba: AI do nhà cung cấp phần mềm tự vận hành
Giữa "tự dựng hoàn toàn" và "dùng AI công cộng" còn một hướng: dùng tính năng AI tích hợp trong phần mềm đang có, do nhà cung cấp phần mềm vận hành. Ví dụ với Zoho, dựa trên tài liệu công khai:
Zia LLM: mô hình ngôn ngữ do Zoho xây dựng với các cỡ 1,3 tỷ, 2,6 tỷ và 7 tỷ tham số (bản 7 tỷ đang ghi "sắp ra mắt"), chạy trên GPU Nvidia trong các trung tâm dữ liệu riêng của Zoho; trang giới thiệu nói dữ liệu không rời khỏi hệ sinh thái Zoho (Zoho Zia LLM). Thông cáo ra mắt (7/2025) cho biết Zia LLM được triển khai ở các trung tâm dữ liệu của Zoho tại Mỹ, Ấn Độ và châu Âu, và Zoho cũng hỗ trợ tích hợp các mô hình khác (Zoho).
Những điều trang Zia LLM chưa nói rõ:
- Dữ liệu khách hàng có bị loại khỏi quá trình huấn luyện hay không.
- Mô hình hỗ trợ những ngôn ngữ nào (có tiếng Việt hay không).
- Gói nào có tính năng này và giá bao nhiêu.
Nếu dùng tích hợp OpenAI trong Zoho: trang quyền riêng tư của Zoho liệt kê dữ liệu nào được gửi đi theo từng sản phẩm. Ví dụ, với Zoho CRM là nội dung trong khung soạn email và một số dữ liệu trường của bản ghi (như công ty, ngành); với Desk là nội dung trao đổi gần nhất của ticket; với Cliq là toàn bộ đoạn hội thoại chưa đọc; với Meeting là bản ghi lời cuộc họp. Trang nói ChatGPT là dịch vụ bên ngoài đặt tại Mỹ, và khách hàng có trách nhiệm bảo đảm minh bạch, thông báo cho người có dữ liệu bị xử lý (Zoho).
Trung tâm dữ liệu của Zoho không có ở Việt Nam. Các tài liệu của Zoho liệt kê số vùng không thống nhất (7 vùng ở trang tài khoản, nhiều hơn ở trang giới thiệu trung tâm dữ liệu). Nếu yêu cầu của bạn là dữ liệu phải nằm trong nước, hãy xác nhận trực tiếp với Zoho.
Câu hỏi nên đặt cho bất kỳ nhà cung cấp phần mềm nào có AI (chúng tôi không mô tả chính sách của các nhà cung cấp khác vì chưa xác minh):
- Dữ liệu của chúng tôi có được dùng để huấn luyện hoặc cải tiến mô hình không? Có cam kết bằng văn bản không?
- Mô hình chạy ở đâu, do ai vận hành? Nếu chuyển tiếp sang bên thứ ba, bên đó là ai và lưu dữ liệu bao lâu?
- Mỗi tính năng AI gửi đi những dữ liệu nào (chỉ câu hỏi, hay cả hồ sơ khách hàng, tệp đính kèm)?
- AI có tuân theo phân quyền hiện có của hệ thống không?
- Có tắt được tính năng AI theo người dùng, nhóm hoặc toàn hệ thống không?
- Có hỗ trợ tiếng Việt không, và có số liệu đánh giá không?
- Nhật ký AI lưu bao lâu, ai xem được?
- Gói nào có tính năng này, giá thế nào?
7. Khung quyết định: chọn theo dữ liệu và tác vụ
Đây là đề xuất của chúng tôi, không phải tiêu chuẩn ngành. Ý tưởng: quyết định dựa trên hai trục, mức độ nhạy cảm của dữ liệu và độ phức tạp của tác vụ.
| Dữ liệu | Tác vụ đơn giản, lặp lại (phân loại, trích xuất, soạn theo mẫu) | Tác vụ phức tạp (phân tích, lập luận nhiều bước) |
|---|---|---|
| Công khai hoặc ít nhạy cảm | Dùng dịch vụ AI công cộng hoặc AI tích hợp trong phần mềm, kèm chính sách sử dụng | Dùng dịch vụ AI công cộng, kiểm tra đầu ra |
| Nội bộ thông thường (tài liệu, quy trình) | AI của nhà cung cấp đã thẩm định, hoặc SLM chạy nội bộ nếu đủ năng lực vận hành | Cân nhắc nhà cung cấp có cam kết bằng văn bản; thử xem SLM có đủ không |
| Nhạy cảm (dữ liệu cá nhân, hợp đồng, tài chính, y tế) | Ưu tiên chạy nội bộ hoặc nhà cung cấp có cam kết rõ ràng, và hỏi luật sư trước | Chưa đưa vào AI cho đến khi có đánh giá rủi ro và biện pháp kiểm soát phù hợp |
Một nguyên tắc đơn giản: đừng chọn công nghệ trước khi phân loại dữ liệu. Nếu chưa biết dữ liệu nào là nhạy cảm, mọi lựa chọn triển khai đều chỉ là đoán. Bài dữ liệu sạch cho AI hướng dẫn bước chuẩn bị này.
8. Kế hoạch chạy thử 30–60 ngày
Vì chưa có bằng chứng độc lập cho tác vụ tiếng Việt của doanh nghiệp bạn, cách duy nhất là tự đo. Đề xuất:
Tuần 1–2: chuẩn bị
- Chọn 1–2 tác vụ cụ thể, hẹp, có người dùng thật (ví dụ tóm tắt cuộc gọi bán hàng, trả lời câu hỏi từ tài liệu sản phẩm).
- Phân loại dữ liệu dùng cho tác vụ đó (mục 7).
- Soạn bộ kiểm tra 50–100 câu hỏi hoặc yêu cầu bằng tiếng Việt lấy từ công việc thật, kèm câu trả lời mong muốn do người trong nghề viết.
- Chọn 2–3 phương án để so sánh (ví dụ một SLM chạy nội bộ, một mô hình lớn hơn, một AI tích hợp của nhà cung cấp), đọc kỹ giấy phép và điều khoản dữ liệu của từng phương án.
Tuần 3–6: chạy thử
- Chạy bộ kiểm tra trên từng phương án; người trong nghề chấm: đúng, sai, đúng nhưng lập luận sai, bịa thông tin.
- Thử cả các tình huống xấu: yêu cầu AI tiết lộ dữ liệu người hỏi không được phép xem, nhúng lệnh độc hại vào tài liệu để xem AI có làm theo không.
- Nếu tự dựng, chạy danh sách kiểm tra bảo mật ở mục 3 và nhờ người độc lập rà soát.
- Đo thời gian phản hồi và mức dùng phần cứng khi nhiều người dùng cùng lúc.
Tuần 7–8: quyết định
- So sánh: tỷ lệ đạt, loại lỗi, chi phí thực (gồm nhân sự), mức rủi ro còn lại.
- Quyết định mở rộng, đổi phương án hoặc dừng, và ghi lại lý do để lần sau không phải làm lại.
Nếu thử nghiệm ổn mà dự án vẫn mắc kẹt ở giai đoạn thử, xem bài vì sao dự án AI mắc kẹt ở giai đoạn POC.
Câu hỏi thường gặp
SLM có phải là AI chạy nội bộ không?
Không nhất thiết. "SLM" nói về kích cỡ mô hình; "nội bộ" nói về nơi mô hình chạy. Hai thứ có thể đi cùng nhau hoặc không.
SLM có đủ dùng cho doanh nghiệp Việt Nam không?
Tùy tác vụ. Có lập luận cho rằng SLM đủ cho các tác vụ hẹp và lặp lại, nhưng chúng tôi chưa thấy bằng chứng độc lập cho tác vụ doanh nghiệp bằng tiếng Việt. Hãy thử trên dữ liệu của bạn.
Chạy AI nội bộ có chắc chắn an toàn hơn dùng dịch vụ bên ngoài không?
Không chắc chắn. Dữ liệu không rời công ty, nhưng bạn phải tự bảo vệ máy chủ; các báo cáo cho thấy rất nhiều máy chủ AI tự dựng đang bị để lộ ra Internet.
Lưu dữ liệu trên cloud nước ngoài có vi phạm quy định chuyển dữ liệu xuyên biên giới không?
Theo cách chúng tôi đọc Nghị định 356/2025/NĐ-CP, việc này nhiều khả năng được coi là chuyển dữ liệu xuyên biên giới và cần hồ sơ đánh giá tác động, nhưng đây không phải tư vấn pháp lý; hãy hỏi luật sư.
Có cần thông báo cho khách hàng khi dùng AI không?
Luật Trí tuệ nhân tạo yêu cầu người dùng phải nhận biết được khi đang tương tác với hệ thống AI, và nhà cung cấp như Zoho cũng nêu khách hàng chịu trách nhiệm thông báo, minh bạch. Chi tiết nghĩa vụ cần luật sư xác nhận.
Nên bắt đầu từ đâu?
Phân loại dữ liệu, chọn một tác vụ hẹp, rồi chạy thử 30–60 ngày theo mục 8 với ít nhất hai phương án.
Kết luận
Câu hỏi "chạy AI nội bộ hay dùng SLM" thực ra gồm ba câu hỏi: dữ liệu nào cần giữ kín, mô hình cỡ nào đủ cho tác vụ đó, và ai đủ năng lực vận hành an toàn. Bằng chứng hiện có ủng hộ hướng "dùng đúng cỡ mô hình cho đúng việc", nhưng phần lớn là lập luận của các bên có lợi ích, và chưa có số liệu độc lập cho tiếng Việt. Vì vậy, việc đáng làm nhất lúc này là phân loại dữ liệu và chạy một thử nghiệm nhỏ có đo đạc.
Nếu bạn đang cân nhắc tích hợp AI vào CRM hoặc quy trình bán hàng và muốn rà soát dữ liệu, phân quyền và cách triển khai trước khi quyết định, đội ngũ Phanmembiz có thể cùng bạn thực hiện.